用 coding agent 做视频:先学会看懂,再让 agent 动手
你已经会让 Codex / Kimi Code 写代码、跑测试、改 bug。但让它帮你做视频,产出常常是「能看,但不想发」。问题的一半在流程——另一半更基础:得先学会看懂一条视频。
为什么有的视频 10 秒就被划走
刷 B 站时你大概率有过这种体验:两条讲同一个话题的科普视频,一条看完想三连,一条 10 秒就划走。区别在哪?多数人只能说出「节奏好」「看着舒服」。
「舒服」不是玄学,它是一组可以逐个指认的零件:画面分了几层、镜头是远是近、风格是否统一、声音怎么托底。能拆,才能装——看懂别人的视频,是让 agent 做出满意视频的前置课。
所以这篇分两段:前半段建立「看懂」的框架,看完你就能拆解任何一条视频;后半段再用这套框架,谈 coding agent 的生产线怎么搭。
一、解剖:视频是叠出来的
暂停任何一条视频,你看到的「一个画面」其实是几层叠在一起的合成结果:背景、主体、图形叠加层(箭头、高亮框、贴纸)、文字层(标题与字幕)。声音虽然看不见,也是独立的轨——人声、BGM、音效各走各的。
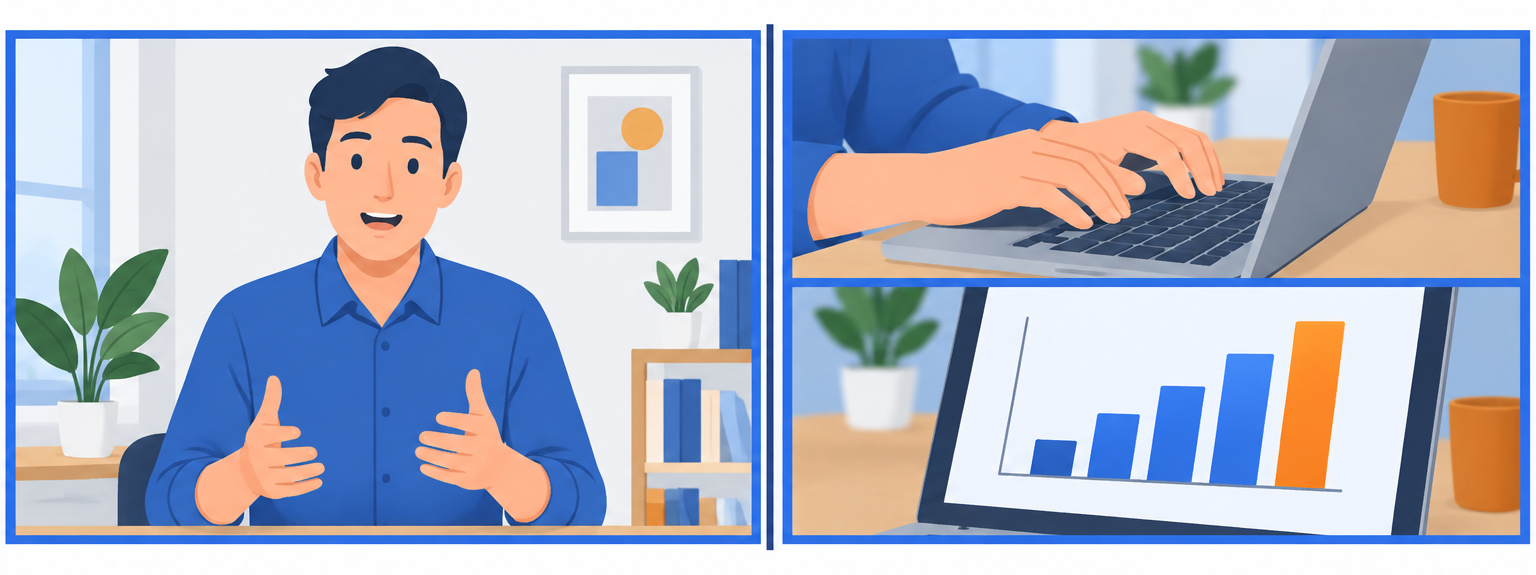
另一种看法不按「层」,按「职能」:主叙事画面叫 A-roll(讲解者对着镜头讲),辅助画面叫 B-roll(手部特写、产品演示、资料画面)。专业视频的呼吸感,大多来自 A-roll 与 B-roll 的交替——一直对着脸讲,10 秒就闷了。
三条轴各回答一个问题,互不干涉——「正交」就是这个意思:来源回答「画面从哪来」,职能回答「它在这段里起什么作用」,图层回答「它叠在第几层」。像填快递单:寄的什么、干嘛用的、怎么打包,三栏各填各的,任意组合都合法。下面逐轴展开。
来源:画面从哪来
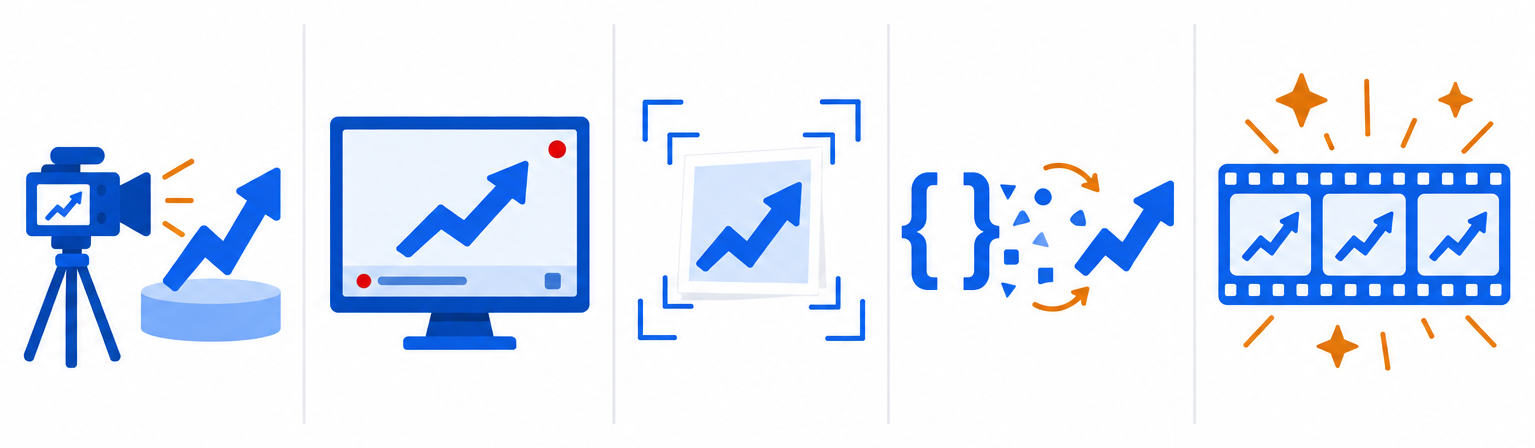
同一个信息,画面可以有十几种来路:拿相机拍(实拍)、把屏幕操作录下来(录屏)、给照片做缓慢推近(静帧运镜)、写代码画图形动画(MG)、让 AI 直接生成视频……这一轴决定的是镜头的成本和工期——选哪条路,价格和返工难度差出一个数量级(下篇细算账)。
职能:它在这段里起什么作用
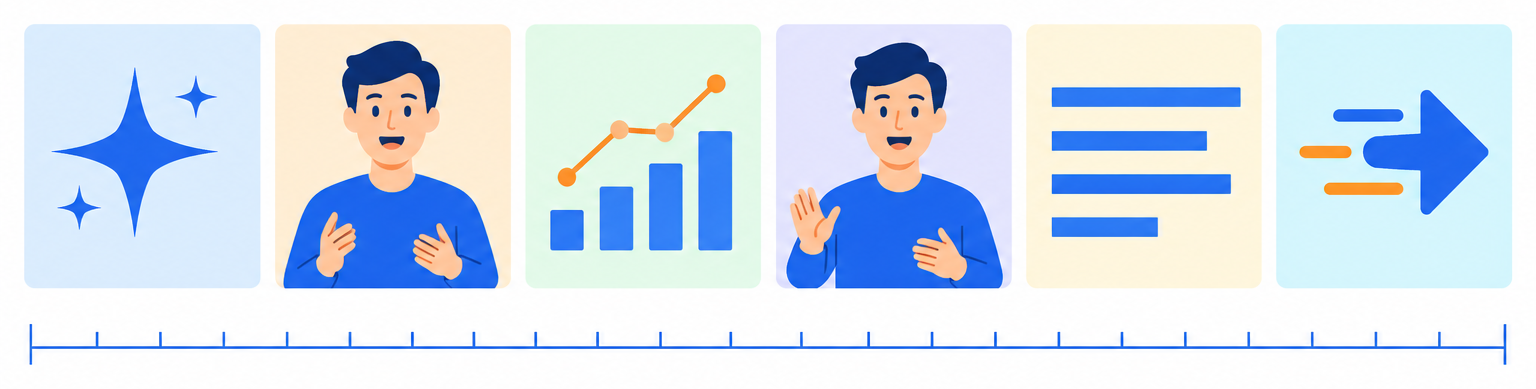
来源管「怎么来的」,职能管「干嘛用的」。拉一条视频的时间轴看:讲解者对着镜头讲的是 A-roll(主叙事),切出去的资料画面是 B-roll(辅助叙事),段落之间的标题卡是章节卡,开头抓人的是钩子。注意:同一段素材可以担不同职能——一段录屏,放开头是钩子,放中段是 B-roll。
图层:叠在第几层
最后一轴回到暂停那一帧:画面是几层叠出来的——背景、主体、图形叠加、文字字幕,外加看不见的音频分轨。这一轴决定的是工程结构:渲染时分几个元素、混音时分几条轨、改的时候动哪一层。
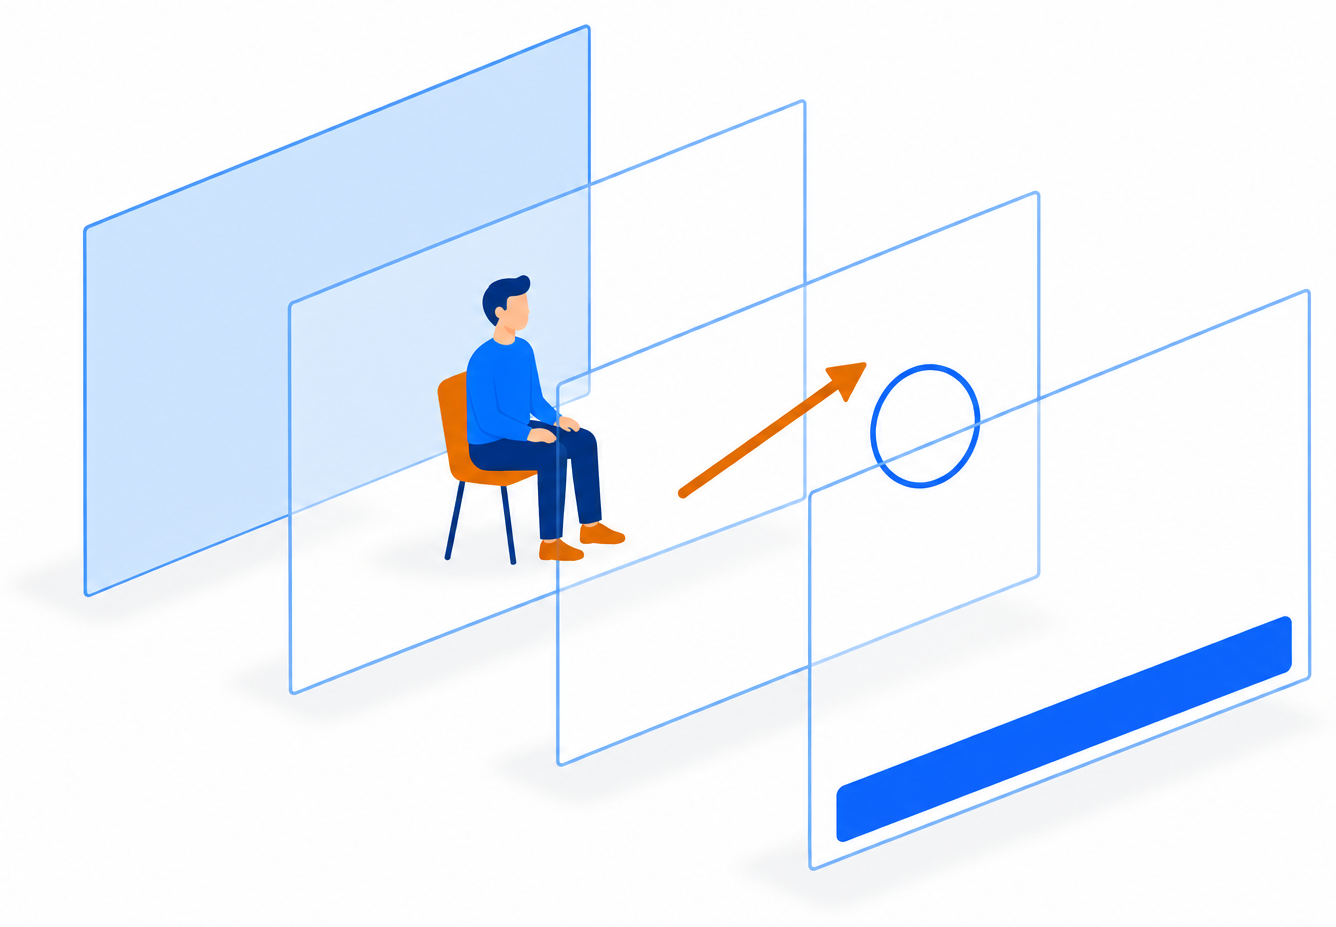
三轴合起来,描述一个镜头就是报出它的三个坐标。以一段「数字从 0 跳到 4 分钟」的计数动画为例(沿图中红色虚线走一遍):它的来源是 ①数据可视化(代码生成的画面),职能是 ②B-roll(给口播配画面),位置是 ③图形叠加层(压在底图之上)。三个坐标一交,这个镜头就被完整描述了:
再拿三个你眼熟的画面练手——以后看到任何镜头,都可以这样报出它的「三轴坐标」:
| 画面 | 来源 | 职能 | 图层 / 轨道 |
|---|---|---|---|
| 讲解者正对镜头说话 | 实拍 | A-roll | 主体层+字幕轨 |
| 录屏上叠着箭头和大字 | 录屏 | B-roll | 主体+图形叠加+文字层 |
| 片尾「求三连」小动画 | MG(代码图形动画) | 章节卡 / 行动号召 | 图形叠加层+音效轨 |
下次看视频时做个小实验:随便暂停一帧,数数这一帧有几层、想想它是什么职能。能回答这两个问题,你就已经开始「看懂」了。但画面还有另一个维度——镜头离你多远。
二、镜头:景别是有含义的
拍同一个人,取景范围不同,观众的心理距离就不同。景别(画面取景的远近)常用五种,各有分工:
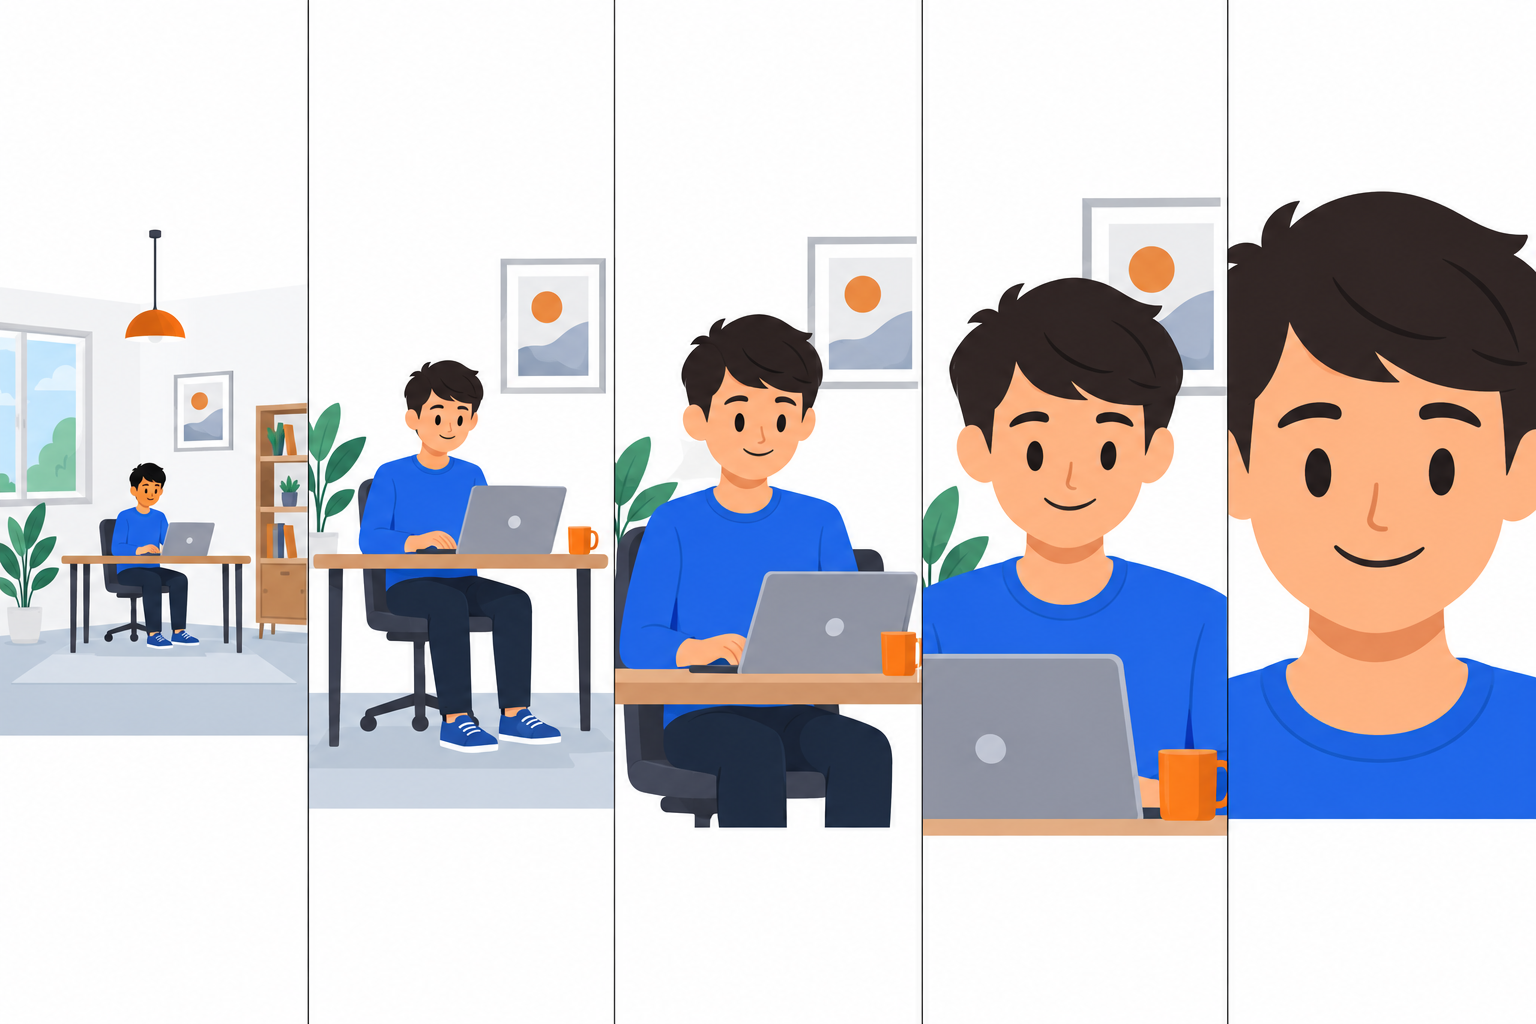
| 景别 | 看到什么 | 叙事含义 | 类比 |
|---|---|---|---|
| 远景 | 大环境,人很小 | 交代环境、情绪留白 | 小说的环境描写 |
| 全景 | 人物全身 | 动作与空间关系 | 舞台全貌 |
| 中景 | 腰部以上 | 叙述主力,讲解标配 | 面对面聊天 |
| 近景 | 胸部以上 | 强调情绪与观点 | 凑近了说 |
| 特写 | 局部占满画面 | 细节、强调、心跳 | 指着给你看 |
还有一条构图常识:三分法——把画面横竖各三等分,主体放在交叉点上,比怼在正中央更有呼吸感。这条对纯图形动画同样成立:重要元素别总居中。景别和构图决定「看多远、看哪里」,接下来是更直观的一层:画面长什么样。
三、气质:风格是选出来的,不是调出来的
视觉风格不是每条视频现挑的,而是先选一条路线,和配色、字体一起写进设计契约(一份给 agent 看的视觉规范文件),之后全系列不换皮。观众记住一个账号,靠的是稳定的视觉气质,不是单条视频的惊艳。
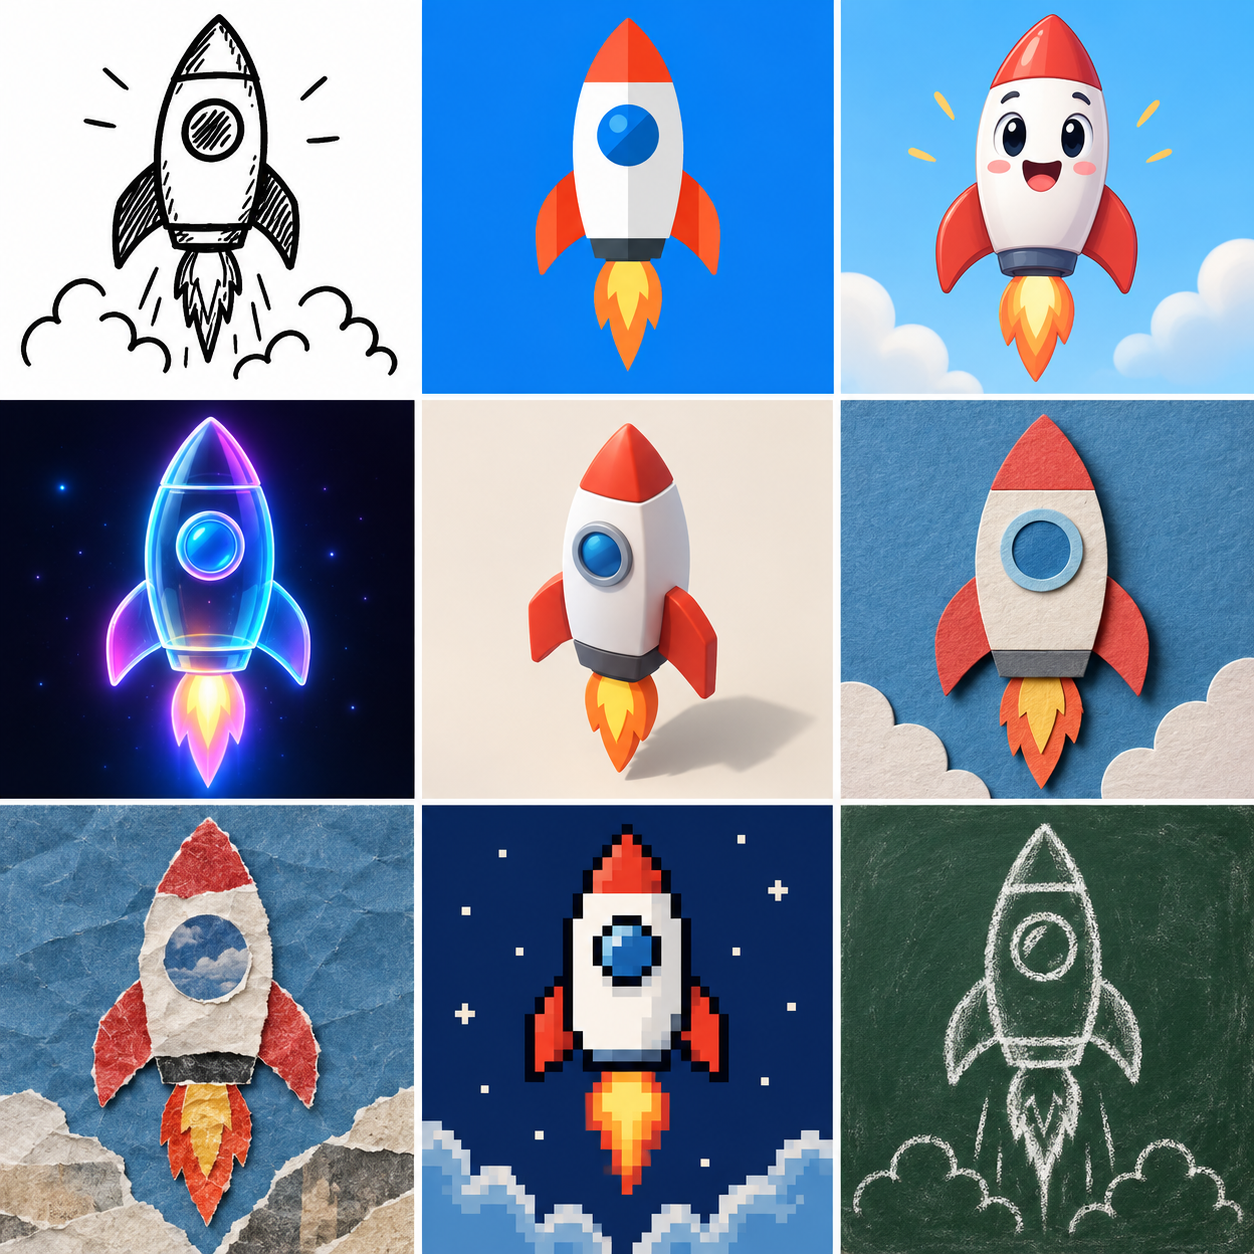
| 风格 | 视觉特征 | 代表作 | 气质 | 适合题材 |
|---|---|---|---|---|
| 手绘涂鸦白板风 | 白底+黑手绘线稿+淡彩马克笔+高亮胶囊 | RSA Animate | 轻松亲切,「有人在你面前画给你看」 | 科普、观点阐释 |
| 扁平矢量插画风 | 纯色几何、无/细描边、大胆撞色 | SaaS 官网动画、Vox | 现代干净、专业感强 | 产品讲解、教程(本文配图即此路线) |
| 卡通角色风 | 吉祥物、表情演出、场景感强 | Kurzgesagt、Duolingo | 故事性强 | 叙事驱动题材 |
| 玻璃拟态/渐变科技风 | 深底、毛玻璃卡片、霓虹渐变、光效粒子 | 大厂发布会、AI 产品宣传 | 高级酷,但与亲和路线相反 | 品牌片、发布会(深底对图表可读性要求高) |
| 等距 3D 风 | 2.5D 等距建筑/管线/场景 | Notion 风插画 | 精致、有空间感 | 系统架构、流程类 |
| 剪纸/纸片风 | 纸质纹理、分层阴影、停格质感 | — | 手作感、温度 | 儿童向、情怀向 |
| 真实素材混剪风 | 录屏/实拍打底+MG 字幕标注叠加 | — | 实用、直接 | 软件教程、产品演示 |
| 像素/复古游戏风 | 像素块、8bit 音色点缀 | — | 怀旧、游戏化 | 游戏、怀旧主题 |
| 黑板/深色手写风 | 深底粉笔字、手绘高亮 | — | 课程感 | 数学、物理讲解 |
四、「讲得清楚」是一门学问
风格定了皮,还有骨:科普视频的核心竞争力是「讲得清楚」。这背后是一套更细的设计知识,共八个域,按对成片的杠杆率从高到低排:
| 知识域 | 管什么 | 一条守则 |
|---|---|---|
| 图解类型学 | 流程/步骤图、对比表、时间线、金字塔/分层、地图、数轴曲线、象限图、代码 diff 卡 | 教学视频 80% 的画面是这 8 种的排列组合,一镜一图 |
| 动效语言 | 缓动曲线的性格、stagger 逐个进入、入出场规范 | 单动作 0.3–0.5 秒,全片动效密度要匀 |
| 多媒体学习原则(Mayer) | 画面与声音如何分工的认知科学 | 画面讲关系、声音讲细节;大字提炼,字幕逐字 |
| 色彩与排版系统 | 60-30-10 法则、字体三件套、对比度 | AI 画面最易翻车处,好在可以写成自动检查 |
| 钩子与叙事骨架 | 开场四型(反直觉/数据/提问/场景)、SCQA、open loop | 镜头时长要有方差,全等长镜头=催眠 |
| 声音设计 | BGM 情绪、音效语义库、ducking(人声出现时音乐自动压低) | 讲解段低能量,结论段上扬 |
| 镜头语言 | 景别、三分法、视线方向 | 纯图形片也能借用,让画面有呼吸 |
| 封面与标题公式 | 封面构图(人脸/大字/高对比)、标题公式、平台调性 | 决定点开率,与内容同等重要 |
这批知识的用法是同一件事:把审美判断翻译成可枚举的选型+可写进文件的规则。agent 没有品味,但会严格执行清单——清单一旦沉淀,第二条视频起边际成本骤降。
动手环节:拆一条你喜欢的视频
不用写代码。找一条你想模仿的 B 站科普视频,0.5 倍速看前三分钟,挑 5 个镜头填这张表:
| 时间点 | 有几层 | 职能 | 景别 | 风格元素 | 声音处理 |
|---|---|---|---|---|---|
| 0:32 | 3 层:录屏+高亮框+大字 | B-roll | 近景 | 扁平风、蓝主色 | BGM 压低,有 whoosh |
| … |
拆完你会发现,「舒服」变成了一张具体的清单——这张清单,就是下半篇要给 agent 的设计契约雏形。
五、你是不是这样做的
设想很顺:定主题 → AI 写文案 → 切成几段 → 每段生成画面和配音 → 拼起来。第一次跑通时很兴奋。
然后你发现:配音和画面对不上;改一句文案,下游全部重做;第十版还不如第一版。
这套流程骨架没错,但它是「幸运时能跑通」的最小流程,不是能稳定产出满意成品的工程流程。下面按环节修。
六、先修流程:音频先行,闸门设好
| 你的假设 | 判定 | 修正 | 类比 |
|---|---|---|---|
| 定个主题,AI 自由发挥 | 缺地基 | 先调研出结果,脚本从调研报告 / 定稿文章里长出来,事实有出处 | 先查资料再动笔 |
| 主题 → AI 写完整文案 | 半对 | 产物是一份视频脚本:分段写,每段带【画面】【口播】【备注】;先审口播栏,再审画面栏 | 剧本不是小说 |
| 切成片段 | 缺标准 | 按信息单元切:一个论点、一个概念、一个动作就是一镜;不按字数均分 | 先画分镜再拍戏 |
| 每段生成素材+配音 | 顺序反了 | 音频先行:TTS 先出真实时长,画面时长反向适配 | 先量布再裁衣 |
| 组合成片 | 被低估 | 对齐、转场、字幕、混音、封面是互相依赖的独立工序 | 不是拼乐高,是装修 |
人工闸门设在「下游返工成本大于一次评审时间」的地方,四个必设:G1 选题/钩子(10 分钟确认,省掉整条视频白做)、G2 口播栏定稿(口播一改,画面配音字幕全废,所以先锁这一栏)、G3 画面栏草图(口播锁定后,在同一份脚本里补逐镜画面,几分钟铺线框看结构)、G4 渲染前终审。闸门太密会拖垮 agent——每次停顿都重置上下文。
七、素材的账:生成是最贵的来源
上篇的三轴里,「来源」这一条轴直接决定成本和工期。对开发者的好消息:教学 / 科普 / 产品宣传的高频组合——录屏+MG+数据可视化+静帧运镜+少量 AI 视频(做氛围 B-roll)——恰好是代码+agent 覆盖最好的一片。这是你相对传统创作者的结构性优势。
你可能会问:这条轴上的来源,是不是都可以交给 AI 完成?基本可以——但「AI 参与」有两种成本结构完全不同的方式:AI 写代码(MG、数据可视化、运镜:确定性产出,可 diff,重试几乎免费)和AI 生像素(AI 视频、数字人、AI 生图:有随机性,按次计费,重试是主成本)。都靠 AI,不改变这张表的结论——便宜的依然便宜,贵的依然贵。唯一的例外是实拍/录屏:录屏可以全自动——agent 能替你操作软件、自己录;实拍不行,AI 视频只能伪造「实拍感」,而观众信的就是真实发生的画面。
| 来源 | AI 参与方式 | 相对成本 | 修改成本 | 适合 |
|---|---|---|---|---|
| 实拍 / 录屏 | 录屏可自动(agent 代操作);实拍不行,真实性不可替代 | 极低 | 低 | 口播、教程、产品演示 |
| 静帧+运镜 | AI 生图+代码运镜(本文配图即如此) | 极低 | 极低 | 补充画面、图集 |
| 纯代码 MG | AI 写代码,确定性产出 | 低(写好可复用) | 极低(改代码) | 图解、数据、章节卡 |
| 数字人 | AI 生像素 | 中 | 中(改稿常要重做) | 口播替代、批量本地化 |
| AI 生成视频 | AI 生像素,按次+重试 | 高 | 高 | 只给无法实拍 / 图形表达的镜头 |
把「每镜素材来源」做成显式字段填进分镜表——它直接决定成本和工期。来源定了,下一个问题是:这些画面用什么工具生产。
八、三个工具,三种物种
剪映、ChatCut、HyperFrames 常被混为一谈,其实它们是三种不同的东西。本质区别是可编程性、可复现性、agent 可驱动性,不是 AI 功能多少:
| 剪映(传统 GUI) | ChatCut | HyperFrames | |
|---|---|---|---|
| 一句话 | 人动手剪:手动时间线+点状 AI 功能 | agent 替你剪:对话驱动真实时间线,还能顺手生成素材 | 没人动手剪:整条视频是代码,渲染即编译 |
| 素材从哪来 | 素材库+自己拍 | 内置一站式生成:AI 视频 / 图片 / MG / 配音 / 音乐 / 数字人 | 画面由代码声明;AI 生成走外部模型,渲染时接入 |
| 类比 | 自动挡代步车(自己开) | 代驾:说目的地它开,最后一公里你随时接管 | 3D 打印机:图纸即产品 |
| agent 驱动 | 无 API | Agent Plugin + MCP,接 Codex 等 | CLI+仓库,进 CI 无障碍 |
| 可复现 | 不可 | 可版本化(生成有随机性) | 同输入同输出 |
| 主战场 | 社交短视频快剪、音乐音效素材渠道 | 实拍口播 / 访谈的 AI 精剪+生成素材补给 | MG、图解、数据视频、批量变体 |
对开发者,剪映的定位是末端精修、音乐音效素材渠道、快速糙稿验证——不是主生产线。它是黑盒 GUI:不可编程、不可批量、工程文件封闭,agent 无法精确驱动。
ChatCut 的关键设计是:agent 的工作成果落在人还能继续精修的真实时间轴上——它取代的是剪映里「人的手工剪辑」环节,而不是剪映本身(还能导出可编辑的剪映草稿,最后一公里自己开)。同时它把素材生产也搬进了同一个对话:AI 视频、图片、MG、配音、音乐、数字人,都能就地生成、直接上轨。
HyperFrames 是 HeyGen 开源的代码框架(Apache 2.0):一个 composition 就是一个 HTML 文件,headless Chrome 逐帧渲染。代码路线的账很直白——优势是可 diff、可批量参数化、风格沉淀为主题包;短板是反馈回路慢、没有素材库和手感、审美要你显式写成设计契约。第一次渲染是草稿,不是成品。
九、务实答案:混合管线
不按「用哪个工具」决策,按「哪道工序用哪个工具」分配:
动手环节:30 分钟最小流水线
- 挑一个已有调研结果的课题——调研报告、定稿文章、笔记都行,它就是脚本的唯一内容来源。
- 花 10 分钟写定位:受众、前 15 秒钩子、目标时长(过 G1)。
- 让 agent 从调研结果起草视频脚本:先只写分段口播,自己朗读一遍再定稿(过 G2)。
- TTS 出音频,拿到真实时长——这一步先于任何画面。
- 在同一份脚本里补每镜画面,必填「素材来源」字段(过 G3)。
- 只做一镜:用代码 MG 做一张数据动画或章节卡,渲染出来看。
- 把配色、字体、卡片样式写成一份设计契约文件——上半篇拆解练习的那张清单就是它的雏形,下条视频直接复用。
边界提醒
| ✅ 本文能帮你 | ❌ 本文不能证明 |
|---|---|
| 用三轴、景别、风格、知识域拆解任何一条视频 | 看懂了就做得出——拆解能力要靠练习积累,不是读完就有 |
| 建立音频先行、分镜独立、闸门到位的工作流 | 保证第一条视频就「满意」——审美判断无法代劳 |
| 按成本与修改成本选每镜素材来源 | AI 视频跨镜一致性已解决——关键帧图再图生视频仍是绕行方案,结论保质期约 6–12 个月 |
| 理解剪映 / ChatCut / HyperFrames 的分工 | 「HyperFrames 对 agent 更友好」有独立基准——厂商评测未公开细节,应视为假说 |
另:剪映价格、字幕准确率、各工具集成的模型清单均随版本变化,调研中标注「待核实」的条目不应作为决策依据,动手前以官方当季信息为准。
小结
- 看懂:视频是「来源 × 职能 × 图层」的叠加;景别有含义,风格写进契约。
- 生产:脚本从调研结果长出来,口播与画面同档分管;音频先行,四个闸门:定位、口播栏、画面栏、终审。
- 工具:剪映、ChatCut、HyperFrames 是三个物种,按工序混着用,不是二选一。
延伸方向:下一篇拆「设计契约」——怎么把配色、字体、动效写成 agent 能直接执行的规范,让第二条视频起边际成本骤降。
🔗 HyperFrames:github.com/heygen-com/hyperframes | ChatCut 文档:chatcut.io/docs
把流程写成代码,把判断留给自己。